(핵심 요약)
결론 : GEO(생성형 엔진 최적화)의 첫걸음은 훌륭한 콘텐츠 작성이 아니라, 자사 웹사이트의 AI 크롤러 접근 차단을 해제하는 기술적 점검이다.
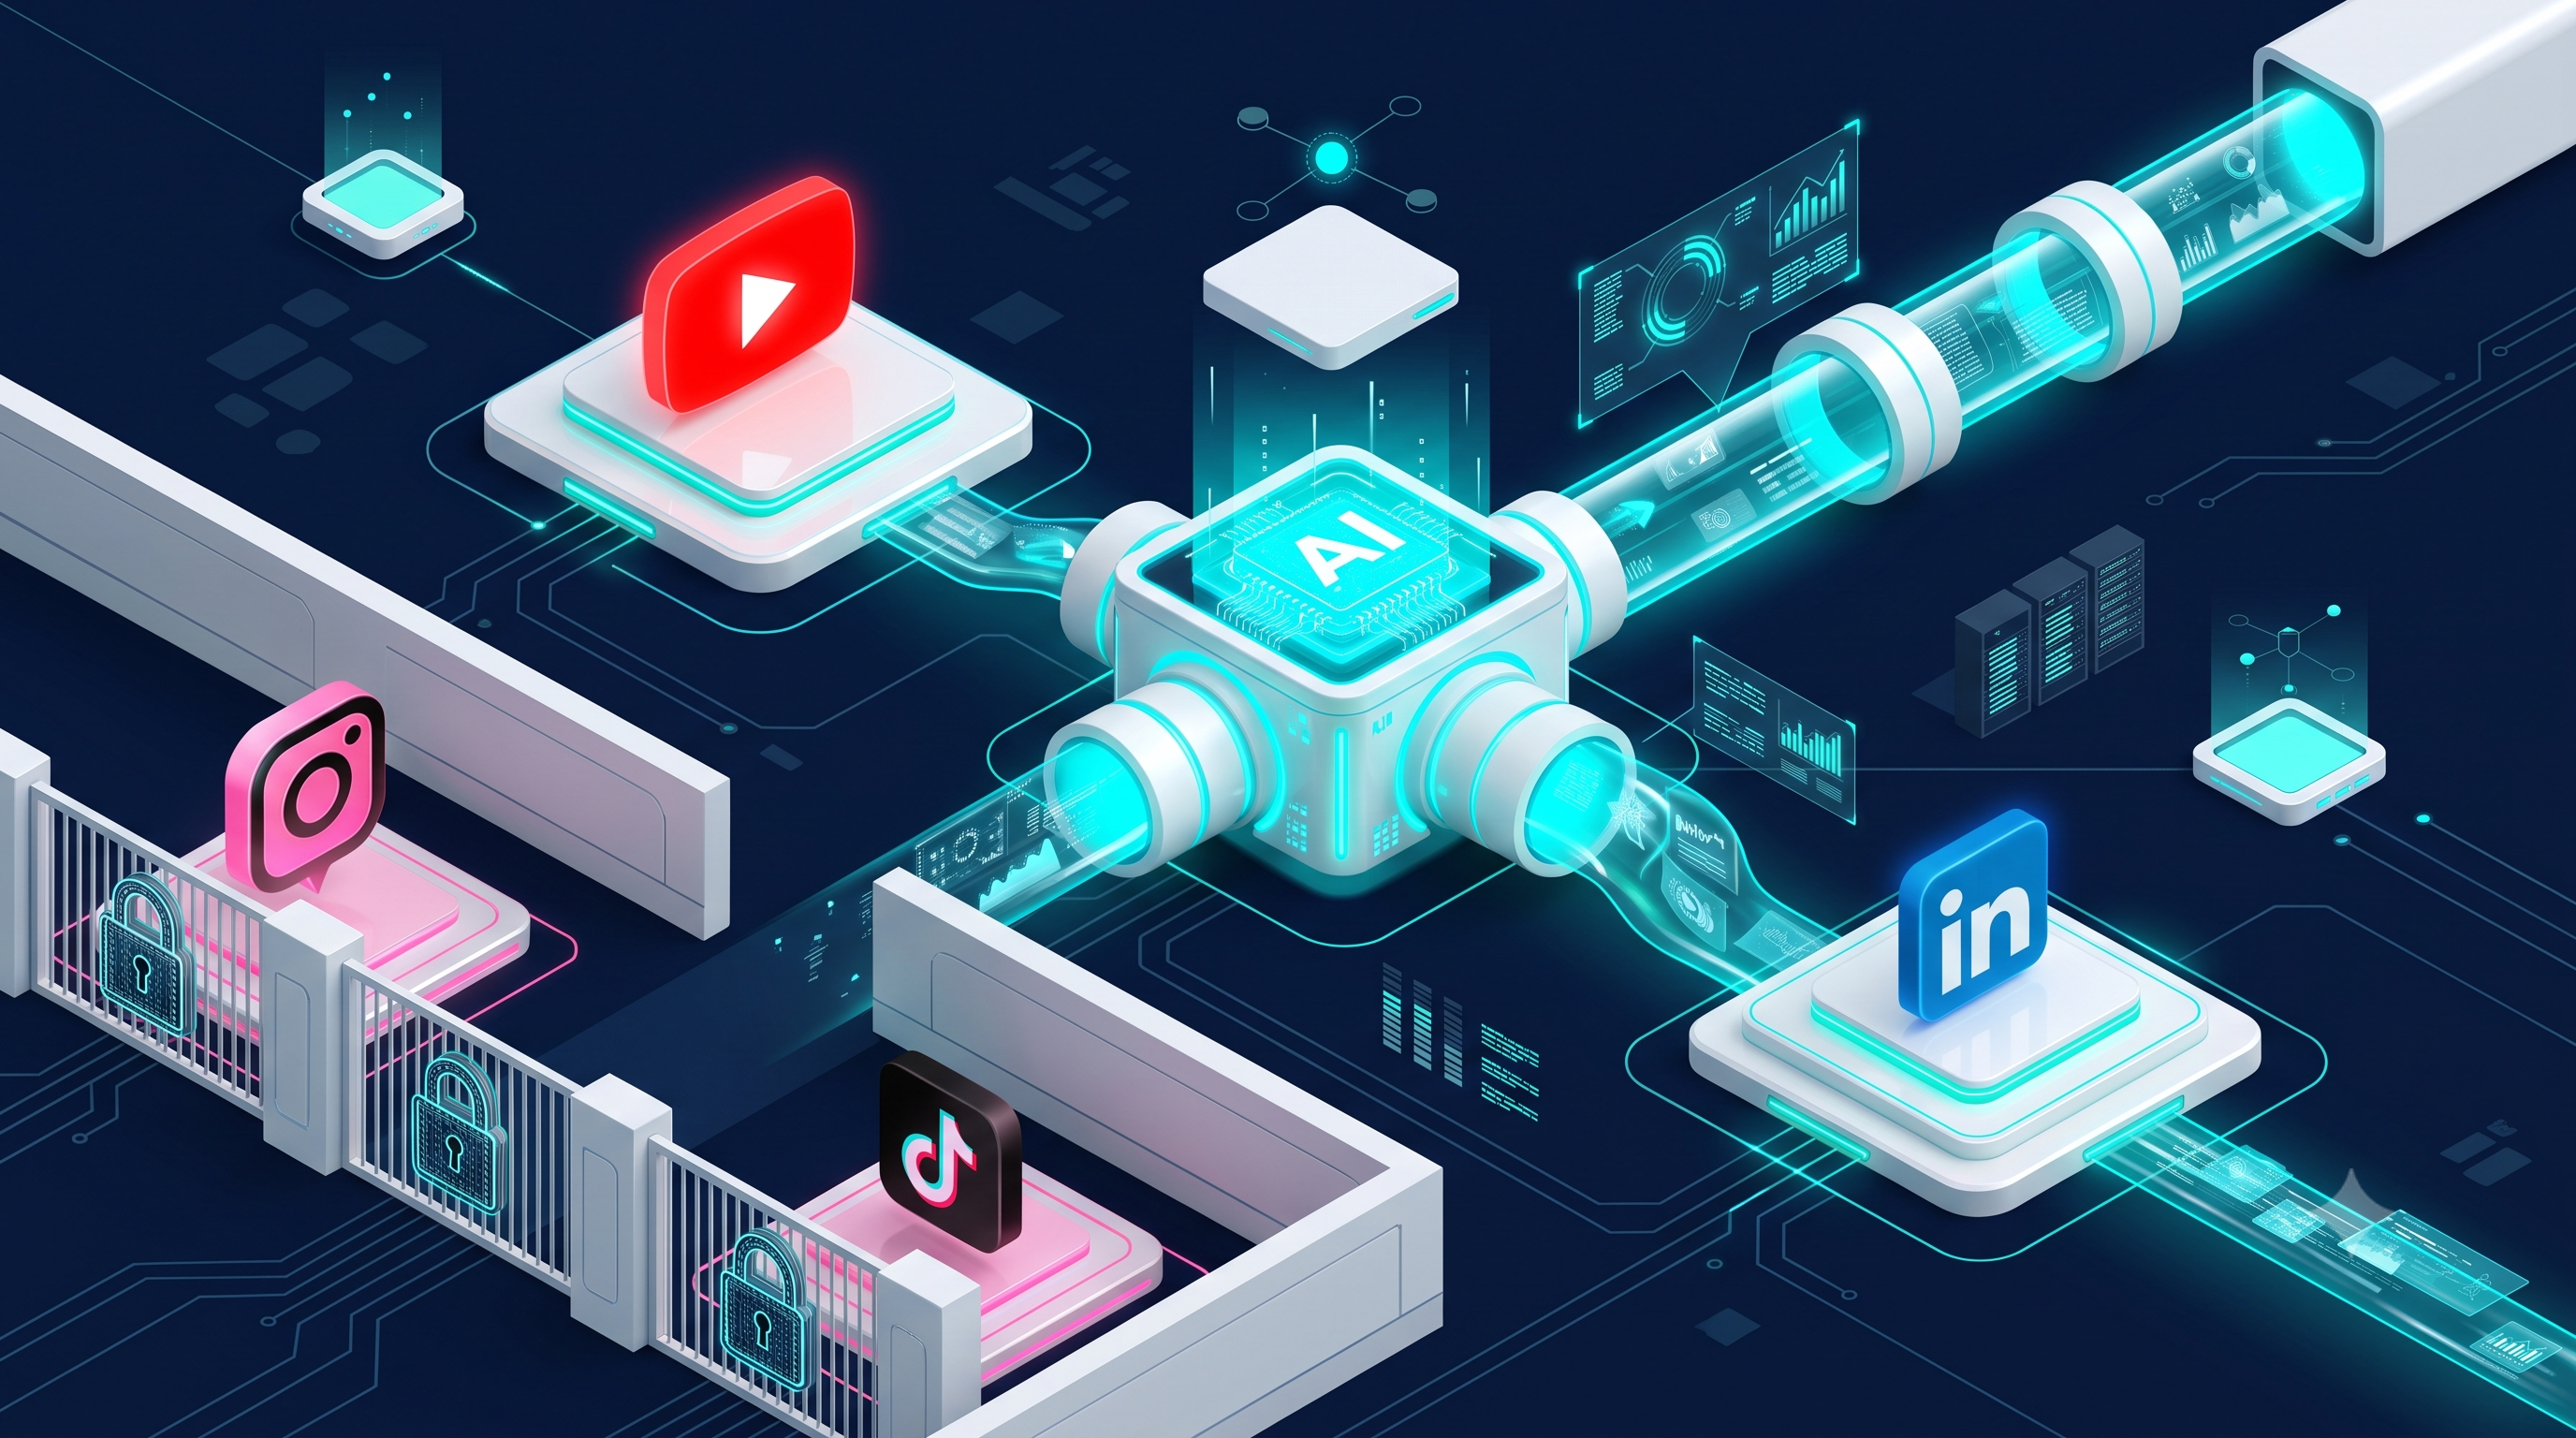
이유 : 기업 보안 방화벽이나 기본 설정이 AI 봇을 악성 트래픽으로 오인하여 차단하면, 아무리 좋은 1차 데이터 표를 만들어도 AI 엔진이 데이터를 학습할 수 없기 때문이다.
핵심 포인트 : robots.txt 확인, HTML 메타 태그 점검, 웹 방화벽(WAF) 로그 분석이라는 3단계 절차를 거치면 기술적 차단 여부를 완벽히 진단하고 해결할 수 있다.
2026년 기업의 디지털 마케팅 성과는 AI 검색 스니펫 인용률에 달려 있다. 하지만 많은 기업이 객관적인 프레이밍과 1차 데이터 표를 완벽하게 구축하고도 왜 우리 회사는 챗GPT나 퍼플렉시티에 정답으로 나오지 않을까?라며 고민한다. 문제의 90퍼센트는 콘텐츠의 질이 아니라 기술적인 크롤러 차단에 있다. 실무자가 개발 지식이 깊지 않아도 즉시 점검할 수 있는 AI 크롤러 차단 확인 3단계 절차와 도구를 분석한다.
1. AI 크롤러 차단이 GEO 성과에 미치는 치명적 영향
AI 검색 엔진은 웹상에 존재하는 수십억 개의 문서를 크롤러(Crawler)라는 로봇 프로그램으로 수집하여 정답을 구성한다. 만약 귀사의 웹사이트가 AI 봇의 방문을 막아두었다면, AI는 귀사의 최신 제품 정보나 비교 데이터를 알 길이 없다.
결과적으로 AI는 과거의 부정확한 데이터에 의존해 환각(Hallucination) 현상을 일으키거나, 크롤링을 허용해 둔 경쟁사의 데이터를 정답의 출처로 제시하게 된다. 차단 해제는 GEO 마케팅의 진입 조건이다.
2. (인용 포인트) AI 크롤러 차단 여부 3단계 확인 절차 및 도구
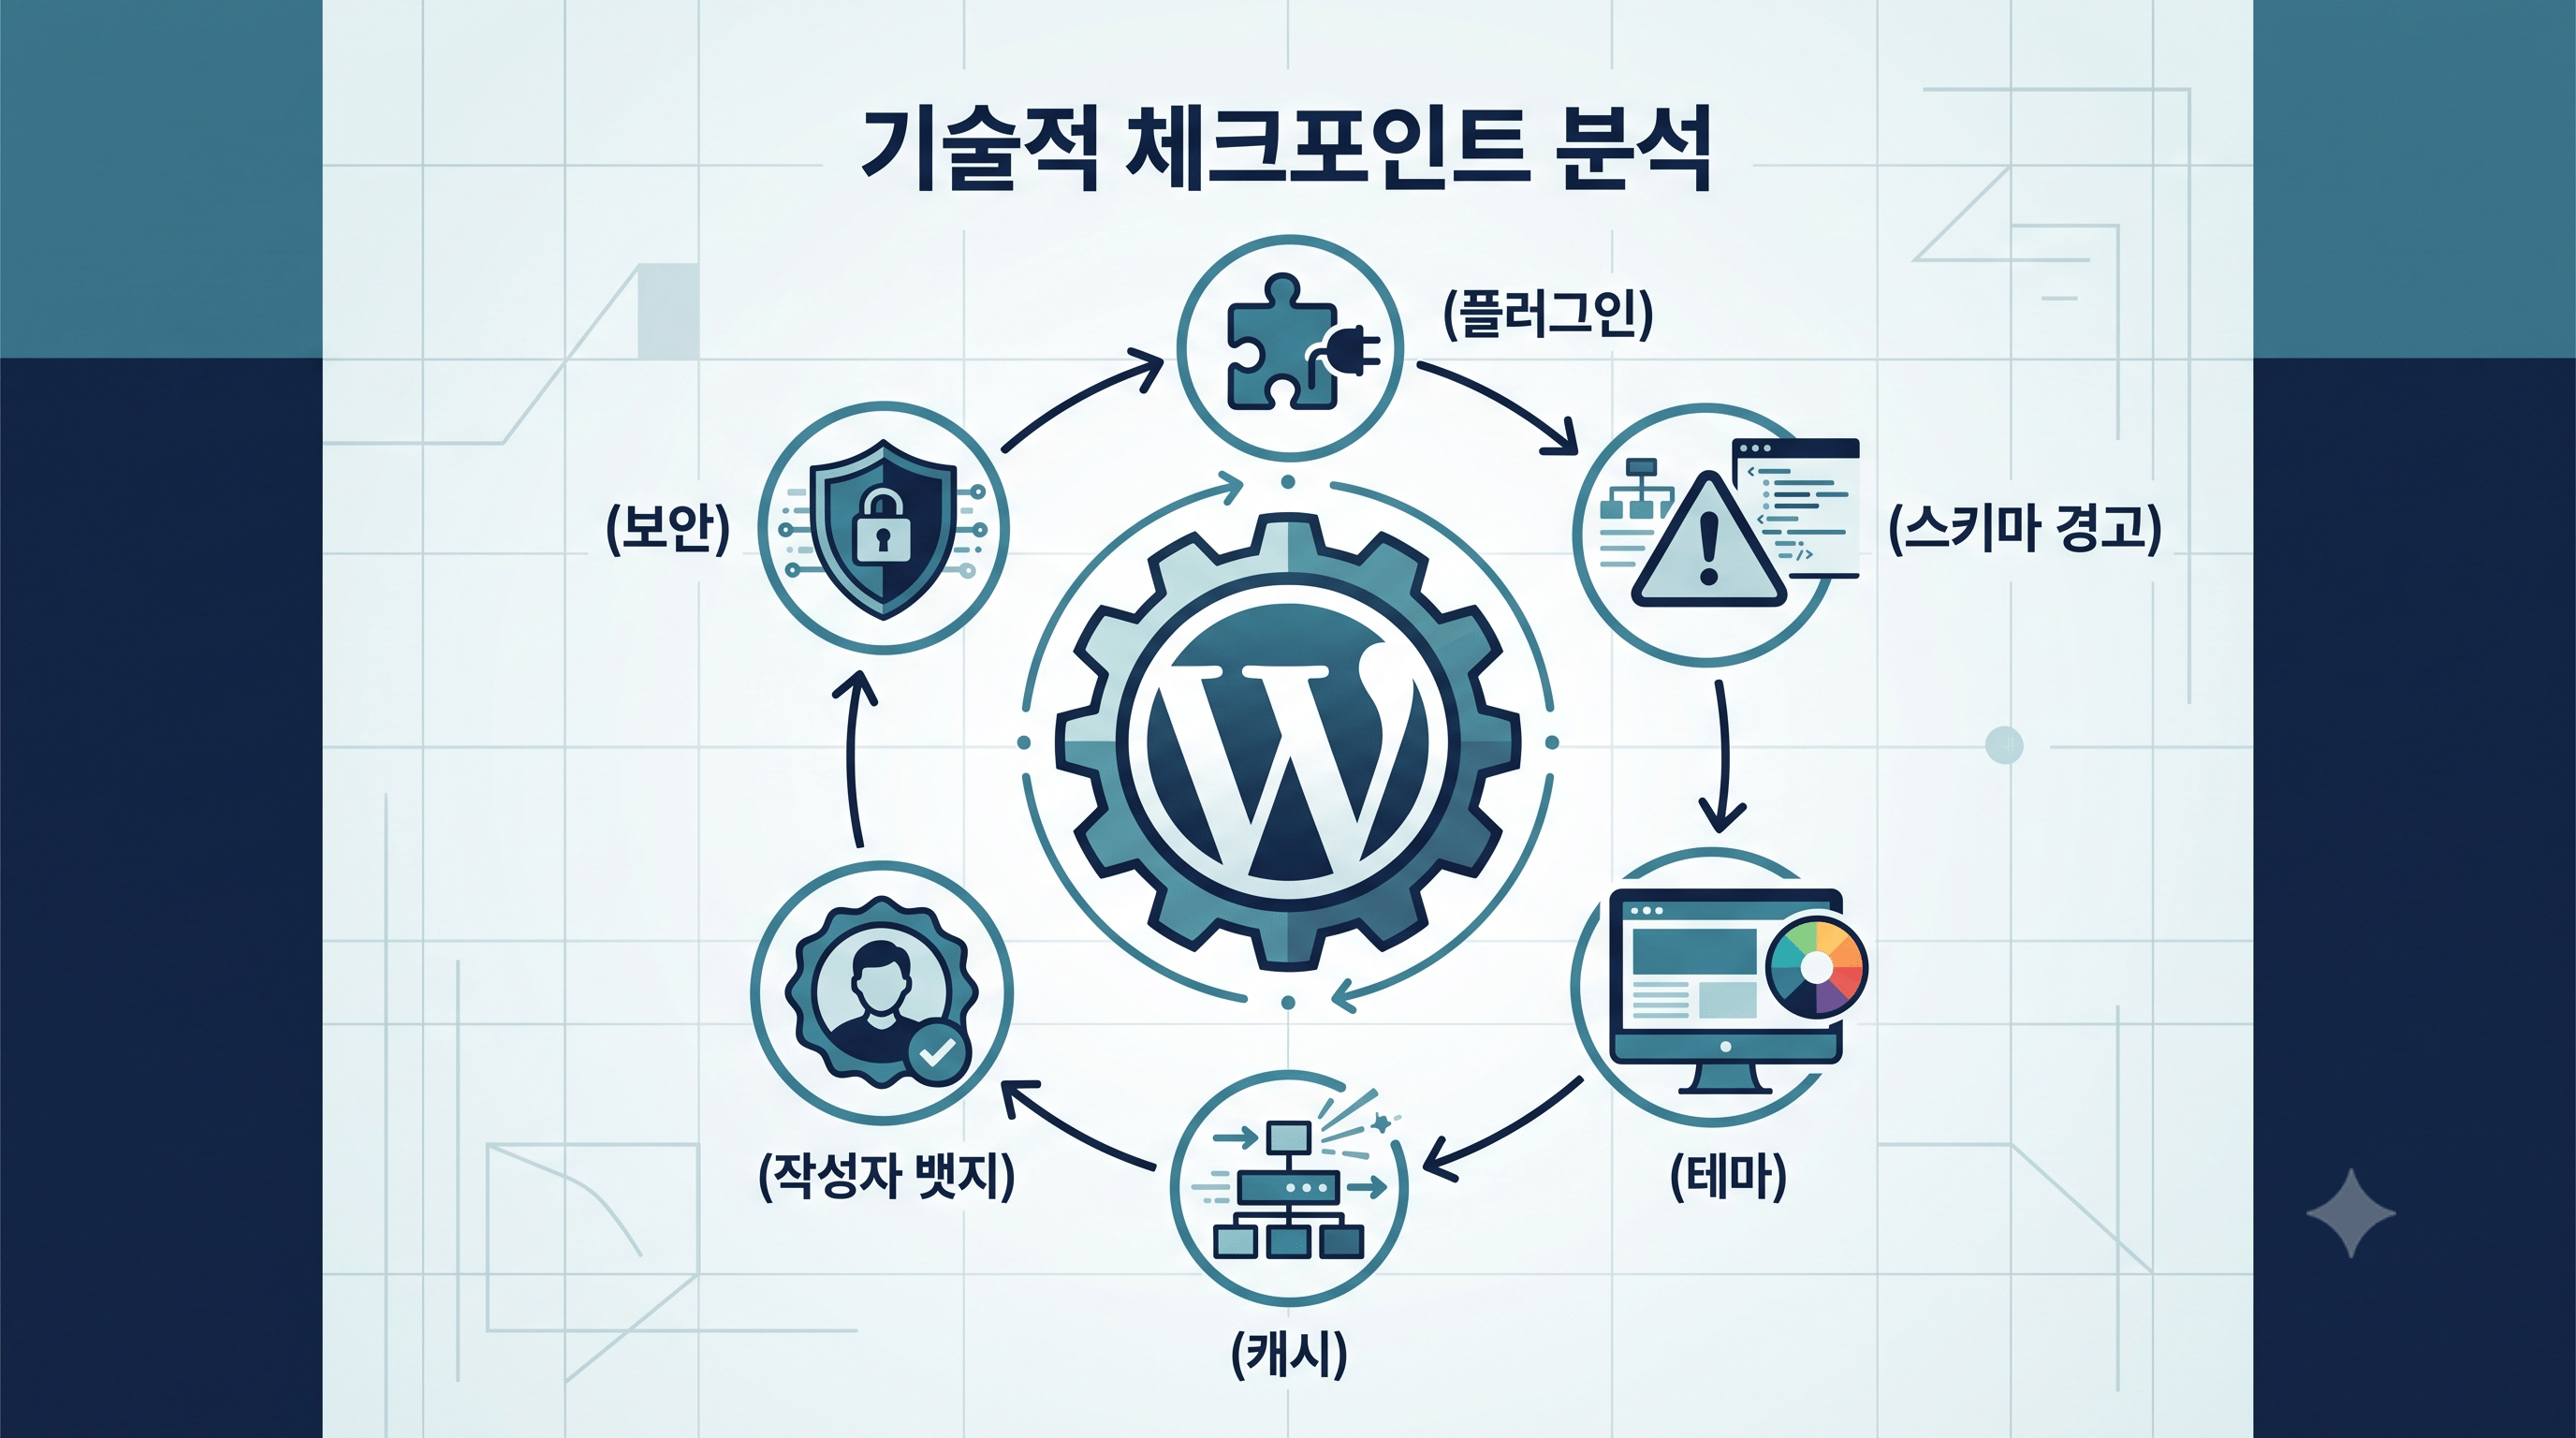
크롤링 차단은 주로 웹사이트의 3가지 계층에서 발생한다. 아래의 3단계 리스트에 따라 차례대로 진단을 수행해야 한다.
| 진단 단계 | 점검 대상 | 활용 도구 | 진단 절차 및 차단 해제 기준 |
| 1단계 | robots.txt (루트 디렉토리) | 웹 브라우저 주소창 | 도메인 끝에 /robots.txt 입력 후, GPTBot이나 PerplexityBot에 대한 Disallow(차단) 구문이 있는지 확인. 차단 시 Allow로 수정 |
| 2단계 | HTML 메타 태그 및 HTTP 헤더 | 크롬 개발자 도구 (F12) | 소스 코드 head 영역에 <meta name="robots" content="noindex">가 있는지 점검하여 삭제 |
| 3단계 | 웹 방화벽(WAF) 및 서버 로그 | AWS WAF, Cloudflare 등 | 보안 솔루션이 AI 봇의 대량 접속을 디도스(DDoS)로 오인해 강제 차단(Drop)하는지 확인 후 화이트리스트 등록 |
(데이터 도출 기준 : 넥스트웹에이아이 2026년 GEO 기술 최적화 점검 매뉴얼)
이러한 3단계 점검 절차를 통해 문을 활짝 열어두어야 AI가 귀사의 1차 데이터를 수집하고 인용할 수 있다.
3. 차단 해제 후 AI 인용률을 높이는 전환 아키텍처
기술적인 차단을 해제했다면, 들어온 AI 봇이 데이터를 쉽게 이해할 수 있도록 웹사이트 내부를 정돈해야 한다.
(1) 1차 데이터의 마크다운 표 시각화
AI 봇은 줄글보다 표를 사랑한다. 제품의 가격, 사양, 서비스 비교 데이터를 마크다운 표로 구조화하면 AI가 해당 데이터를 그대로 복사하여 사용자에게 보여줄 확률이 급증한다.
(2) 스키마 마크업(Schema Markup) 적용
차단이 해제된 웹사이트 코드 내에 Article, FAQPage 등의 스키마 마크업을 삽입한다. 이는 AI 크롤러에게 이 데이터는 질문과 답변입니다라고 명확히 번역해 주는 이름표 역할을 하여 데이터 수집 속도를 극대화한다.
(3) 마찰 없는 행동 유도 (CTA)
정상적으로 스니펫에 인용되어 유입된 잠재 고객이 이탈하지 않도록, 문서 하단에 넥스트웹에이아이 GEO 진단 신청과 같은 명확한 행동 유도 버튼을 배치해 최종 전환을 이끌어낸다.
(FAQ) 자주 묻는 질문
Q1. AI 봇을 모두 허용하면 웹사이트 서버 속도가 느려지나요?
A1. 일시적으로 트래픽이 늘어날 수 있으나 최신 웹 서버 환경에서는 무리가 가지 않는 수준이다. 속도가 우려된다면 robots.txt 파일에 Crawl-delay 설정을 추가하여 봇의 수집 속도를 조절하면서 차단은 해제하는 것이 현명하다.
Q2. 차단을 해제했는데도 바로 챗GPT에 노출되지 않습니다.
A2. 봇을 허용했다고 해서 과거의 데이터가 즉시 반영되는 것은 아니다. 차단 해제 후 구글 서치 콘솔 등을 통해 재색인(Re-indexing)을 요청하고, AI가 귀사의 웹사이트를 새롭게 수집하여 학습할 때까지 평균 1~2주의 시간이 소요된다.
Q3. 자사 웹사이트의 크롤링 현황을 실시간으로 보는 방법이 있나요?
A3. 구글 서치 콘솔의 ‘크롤링 통계’ 메뉴나 서버의 Access Log를 분석하면 어떤 종류의 AI 봇(예: OAI-SearchBot)이 하루에 몇 번 다녀갔는지 정확히 모니터링할 수 있다.